ViTok-v2:把 Autoencoder 做到 5B,真正放大的是什么?
这篇最重要的结论很具体:固定 latent 大小以后,继续扩大 decoder,仍然能把 reconstruction-generation 的 Pareto frontier 往外推。 Encoder 保持浅层;主要 capacity 用来学习如何从压缩表示恢复 RGB。
论文:ViTok-v2: Scaling Native Resolution Autoencoders to 5 Billion Parameters
项目:ViTok-v2 project page
公开实现:Na-VAE/vitok-release
研究背景与前置工作
论文的 Background 在讲什么
ViTok-v2 把 autoencoder 设计中两个经常混在一起的 trade-off 拆开处理。
第一个是 pixel fidelity 与 perceptual quality 的冲突。L1 / L2 更照顾 PSNR、SSIM;LPIPS 和 GAN 更照顾 FID 一类的感知指标,但会牺牲逐像素准确度。GAN 还带来额外的训练不稳定性:ViTok-v1 的 decoder 到约 350M 后就很难继续 scale。
第二个是 reconstruction 与 generation 的冲突。compression ratio r 越低,latent 保留的信息越多,reconstruction 越容易;但 generator 要学习的 latent 维度也更高。论文因此提出一个更具体的假设:固定 r 时扩大 decoder,可以改善 reconstruction 而不增加 generator 的输入维度;扩大 generator,则可能真正利用 low-r 的 richer latent。
还有一个更实际的限制:CNN autoencoder 依靠 translation invariance,天然更容易跨 resolution 和 aspect ratio;现有 ViT tokenizer 往往绑定训练分辨率与 absolute position embedding。ViTok-v2 要做的,是把 ViT autoencoder 的 scaling 优势保留下来,同时补上 native-resolution generalization。
三篇直接前置工作
Learnings from Scaling Visual Tokenizers for Reconstruction and Generation(ViTok-v1)
2025-01 · UT Austin;GenAI, Meta;FAIR, Meta;Stanford · 引用 0
直接前作。它先把 bottleneck、encoder / decoder scale 与 reconstruction-generation trade-off 拆开研究;ViTok-v2 的 asymmetric scaling 和 r 讨论都从这里接着走。
Patch n' Pack: NaViT, a Vision Transformer for any Aspect Ratio and Resolution
2023-07 · Google DeepMind · 引用 16
Native-resolution ViT 的直接机制来源:输入保留宽高比,使用可变 token 数和二维位置,省去统一的正方形 resize。
DINOv3
2025-08 · Meta AI Research;WRI;Inria · 引用 24
ViTok-v2 用冻结 DINOv3-S 的多层 feature 比较原图与 reconstruction,形成关键 perceptual signal。约束发生在 reconstruction image space,latent 没有直接对齐 DINO feature。
时间窗口:ViTok-v2 首次公开日前 3 年。时间口径:arXiv v1 首次公开月份。引用数:OpenAlex
cited_by_count,查询于 2026-08-13;动态数据只作传播度参考。ViTok-v1 的0可能来自索引覆盖不足,不代表其研究影响力。
它到底在解决什么
上面的背景最后收束成一个实验问题:怎样在不改变 latent budget 的前提下,把 reconstruction-generation 的 Pareto frontier 往外推?
AE capacity 和 generator capacity 都能移动这条曲线:
固定 r,扩大 Autoencoder decoder
-> latent 的大小没有变
-> generator 面对的输入维度没有变
-> reconstruction 可以继续变好

固定 AE,扩大 generator
-> 更有能力利用 low-r 的 richer latent
-> generation 可以追上来
原版 ViTok 没把这件事验证到底。GAN loss 让 decoder 超过约 350M 后很难稳定训练;固定 256×256 + absolute position embedding 又导致换分辨率就出问题;生成实验也只有一个 450M flow model。
论文在 Introduction 把贡献列成五项。
Introduction 原文贡献翻译:
- 提出首个支持 native aspect ratio 的 ViT autoencoder:把 NaFlex-style training 与 2D RoPE 结合,使在 256p 训练的 ViTok-v2 可以泛化到 512p、1024p 和不同宽高比。
- 把 continuous ViT image compression autoencoder 扩到 5B 参数,其中 decoder 4.5B、encoder 463M;相比 ViTok-v1 的 350M 放大超过 14 倍,并在不使用 adversarial training 的情况下达到强重建结果。
- 提出 DINOv3 perceptual reconstruction loss,用它同时替代 LPIPS 和 GAN objective,以支持 billion-scale 稳定训练。
- 联合研究 AE 与 flow model scaling:组合 350M / 5B AE、450M / 1.2B flow model 和多种 compression ratio,发现大 generator 更能利用低
r的 richer latent,小 generator 则在高r上更好。 - 系统比较 KL、tanh + noise 与 LayerNorm regularization,发现模型 scale 上去后,它们对 generation quality 的影响很小,因此可以采用更简单、确定性的 encoder。
AI总结的论文贡献:
- 把 ViT autoencoder 从 fixed-resolution model 变成 native-resolution tokenizer。 NaFlex-style training 与 2D RoPE 负责 resolution / aspect ratio generalization,inference-time sliding-window attention 负责高分辨率下的计算效率。
- 把 continuous image autoencoder 稳定扩到 5B。 浅 encoder + 大 decoder 延续 asymmetric architecture;DINOv3 perceptual loss 替代 LPIPS / GAN,让 decoder scaling 不再被 adversarial training 卡住。
- 把 tokenizer 设计放回 AE 与 generator 的联合系统里判断。 最优 compression ratio 会随 generator capacity 改变;在 billion-scale 下,LayerNorm 已足以提供简单、deterministic 的 latent regularization。
先把 compression ratio 算清楚
论文定义:
f 是空间下采样倍率,c 是每个 latent token 的 channel 数。r 表示每个 latent scalar 平均承担多少个 RGB scalar。r 越大,压缩越狠。
以 256×256 图片为例:
| 配置 | latent grid | channel | latent scalars | r |
|---|---|---|---|---|
f16×64 | 16×16 | 64 | 16,384 | 12 |
f16×32 | 16×16 | 32 | 8,192 | 24 |
f16×16 | 16×16 | 16 | 4,096 | 48 |
据论文公式计算,原图共有 256×256×3 = 196,608 个 scalar:196,608 / 16,384 = 12。这里的 r=12 表示 scalar compression ratio;spatial downsample 仍是 f16,latent channel 为 64。
这也解释了为什么 r=48 更依赖 decoder:输入只剩 4,096 个 latent scalar,却要恢复 196,608 个 RGB scalar。
模型结构:真正大的部分在 decoder
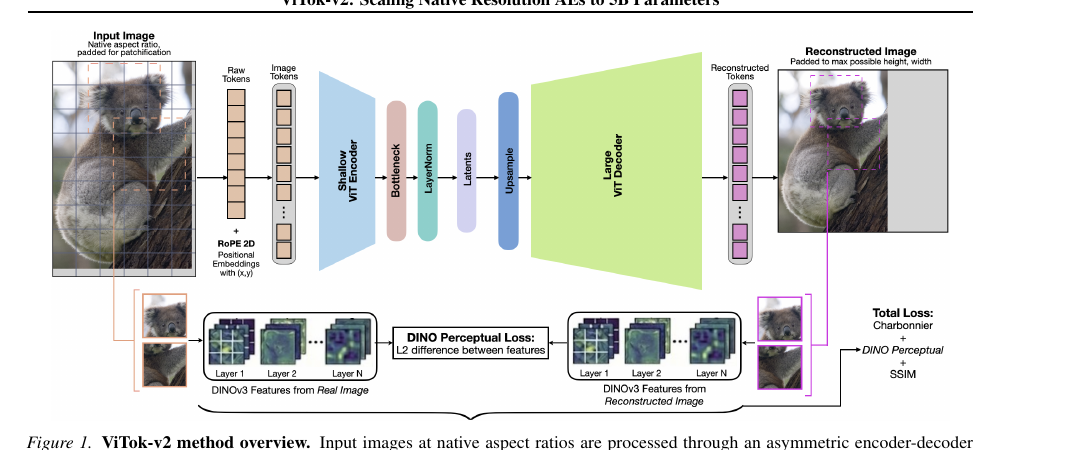
Figure 1 对应代码(作者公开重实现,commit a90f23b):非对称 encoder / decoder 构造 ae.py L68–157 · encode 路径 L189–216 · decode 路径 L218–243。代码身份:Philippe Hansen-Estruch 的 independent public reimplementation;Meta 内部原始实现未公开。
p×p · p∈{16,32}4 blocks12–40 blocks最大模型 Td4-T/16×64
- Encoder
- width 3072 · depth 4 · 24 heads · 约 463M
- Decoder
- width 3072 · depth 40 · 24 heads · 约 4.5B
- 参数分配
- 总计接近 5B · 约 90% 在 decoder
论文把 decoder 从 B / L / G / T 依次扩到 88M / 302M / 1.1B / 4.5B。Encoder 一直保持浅层;d=4 和 d=8 基本重合。
Table 1 给出了 shallow encoder 的下限。4 blocks 降到 1 block,SSIM 只从 .768 到 .753;换成纯 linear projection 则掉到 .462。Depth 可以很浅,但 encoder 仍需要非线性。
另一个限制来自 width。Patch size 32 时,一个 RGB patch 有 32×32×3 = 3072 个 scalar。论文发现 encoder/decoder width 也要接近 3072;B 模型 width 768 的 SSIM 只有 .432,T 模型 width 3072 达到 .872。
参数分配同时受 width 与 depth 两个条件约束:
encoder width 先覆盖每个 patch 的输入维度
encoder depth 保持很浅
剩余参数主要堆 decoder
Decoder scaling 在高压缩率上更值钱
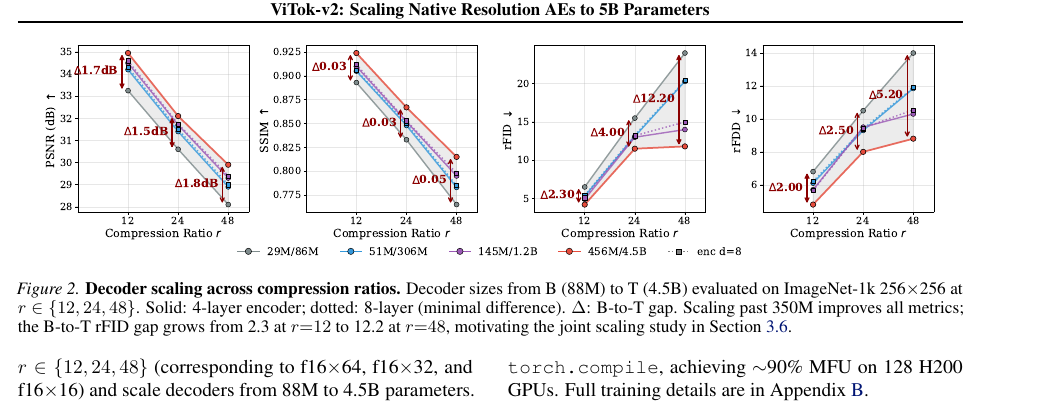
Figure 2 真正要看的是红色标注的 B-to-T gap:
B → T decoder scaling
r=122.3r=244.0r=4812.2压得越狠,大 decoder 的收益越大。这符合任务本身:低维 latent 丢掉或混合了更多局部信息,decoder 要依赖更强的全局建模能力恢复 RGB patch。
但这里不能写成“大 decoder 补回了已经丢失的信息”。信息真的被 bottleneck 删除以后,任何 decoder 都恢复不了。它能做的是:在同一个 latent budget 下,让 encoder 学会保留更有用的信息,并更好地利用跨 token 关系完成反演。
Native resolution:训练分辨率之外的泛化怎么得到
NaFlex 训练先保留原始 aspect ratio,再把图片 resize 到 sampled token budget,pad 到 patch size 的整数倍。不同长度的 patch sequence 用 boolean attention mask 打包;位置用二维行列坐标做 2D RoPE。
训练分两段:
前 90%:256-token budget,约等于 f16 下的 256p
后 10%:1024-token budget,约等于 f16 下的 512p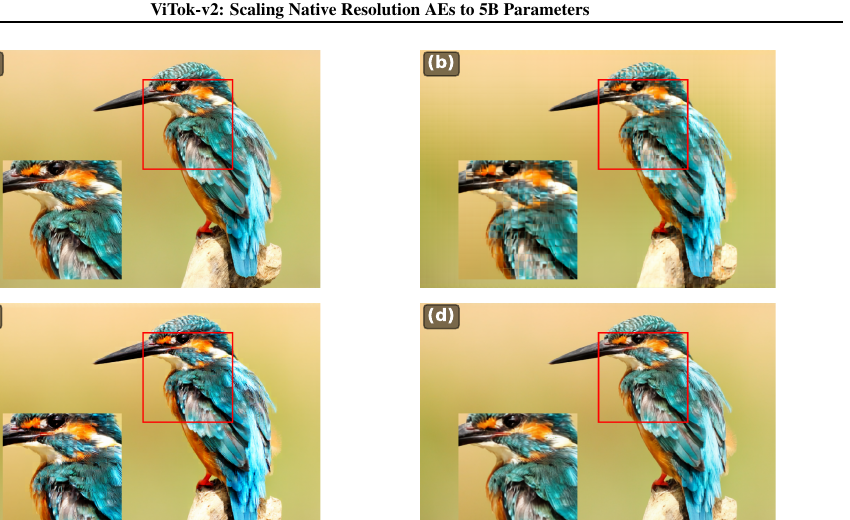
Figure 3 对应代码(同一公开重实现):native / square 混合预处理与 token budget train_vae.py L238–245 · patch、row/col 坐标与有效 token mask ops.py L217–285 · 2D RoPE 坐标进入 AE ae.py L162–171。这几个入口把图里的 native-resolution image → variable patch sequence → 2D position 串了起来。
这张图看鸟的头部放大区域:固定 256 crop 的模型在 1024p 出现明显 patch grid;只加 256-token NaFlex 后大幅减轻;最后 10% 再用 1024-token budget,网格基本消失。
推理时还有一个很实用的操作:训练全程使用 full attention,但高分辨率 inference 直接换成 2D sliding-window attention,radius 8。每个 query 只看 (2×8+1)^2 = 289 个邻域 token,复杂度从 O(L²) 降到近似 O(L·r²)。
论文结果显示质量下降很小;同一套 full-attention checkpoint 可以在 inference 时直接切换到 SWA。
DINOv3 loss:在 reconstruction space 比较多层 feature
这里先把约束对象说清楚:DINOv3 只比较原图与 reconstruction 的 feature,不直接规定 latent 应该长成什么样。
输入图和重建图从相同位置各裁一个 224×224 tile,经过冻结的 DINOv3-S;抽取多层 intermediate token features,逐 token 做 L2 normalization,再计算 feature MSE。梯度经 reconstruction 回到 decoder 和 encoder,DINOv3 weights 保持 frozen。
real image tile --------> frozen DINOv3-S -> multi-layer features --\
                                                                    -> MSE
reconstructed tile -----> frozen DINOv3-S -> multi-layer features --/

gradient -> reconstructed image -> decoder / encoder
DINOv3 weights frozen
为什么先裁 tile?DINOv3 使用 fixed positional embedding。统一切到 224 后,native-resolution 图片可以复用同一个 frozen feature network,同时避开 DINO position embedding 的任意尺寸外推。
总 loss:
默认 λp=500;偏感知的版本用 λp=1000。
Loss 代码定位(同一公开重实现):Charbonnier / SSIM / DINO 默认权重 train_vae.py L67–75 · DINO perceptual module 初始化 L253–259 · Charbonnier 与总 loss L314–368 · 同位置 tile 采样 ops.py L368–427。这里还能看到一个实现差异:论文写 224×224 tile,公开重实现参数默认是 tile_size=256;因此代码只能作为公开 recipe 的证据,不能替代论文原始训练配置。
ImageNet-1k 256p、5B r=12 的 ablation:
| Loss | rFID↓ | rFDD↓ | SSIM↑ |
|---|---|---|---|
| pixel-only | 5.13 | 10.96 | .929 |
| + SSIM | 4.87 | 10.42 | .931 |
| + LPIPS | .72 | 2.93 | .923 |
| + DINO, λ=250 | .51 | 1.45 | .919 |
| + DINO, λ=1000 | .30 | 1.12 | .914 |
| + LPIPS + DINO | .38 | 1.35 | .918 |
DINO-only 优于 LPIPS;叠加 LPIPS 后 rFID 从 .30 变成 .38。最终 recipe 用 DINO 提供 perceptual signal,并移除了 GAN。
perception-distortion trade-off 仍然存在。把 λp 从默认值提高到 1000,ImageNet rFID 从 .74 降到 .30,PSNR 同时从 34.2 dB 降到 33.6 dB。这组设置用 0.6 dB PSNR 换取更低的 perceptual distance。
Appendix Figure 6 把两种 scaling 分得很清楚。固定 loss、增大 decoder 时,PSNR / SSIM 与 rFID / rFDD 可以同时改善,整条 perception-distortion frontier 向外移动;固定 T decoder、只调 loss 时,rFID 可以在 .3–5.1 之间变化,而 SSIM 只落在 .914–.931 的窄区间。decoder scale 决定 frontier 能走到哪里,DINO weight 决定最终落在哪个 operating point。 论文最强的区域来自两者叠加。
Latent regularization:论文内部有一个需要保留的版本差异
§3.5 比较了三种设置:
| Regularization | rFID↓ | gFID↓ | gFDD↓ | IS↑ |
|---|---|---|---|---|
| KL,β=.01 | .43 | 4.71 | 5.32 | 181 |
| tanh + noise,σ=.01 | .42 | 5.02 | 5.42 | 178 |
| LayerNorm | .43 | 4.73 | 5.24 | 185 |
实验条件是 5B f16×64 AE + 450M flow,ImageNet-1k 256p,训练 100 epochs。三种 gFID 在 4.7–5.0,论文因此选择更简单、确定性的 LayerNorm。
但 Appendix A.1 仍把 encoder design 描述成 tanh-bounded output + Gaussian noise。这和正文最终选择不一致。
代码实际:vitok-release 的身份是 independent public reimplementation;Meta 内部原始训练代码未公开。当前 AE 初始化的 L118–122 定义 LayerNorm(channels_per_token),encode 的 L201–215 在 to_code 后直接执行它,没有 tanh/noise。公开 checkpoint registry L7–20 也确实提供 5B-f16×{16,32,64} 与 5B-f32×{64,128,256}。
更稳妥的记录是:正文消融支持 LayerNorm,公开重实现也采用 LayerNorm;附录的 tanh+noise 可能来自未同步更新的配置描述。论文尚无正式勘误,这一点保留为推断。
AE 和 generator 要一起看
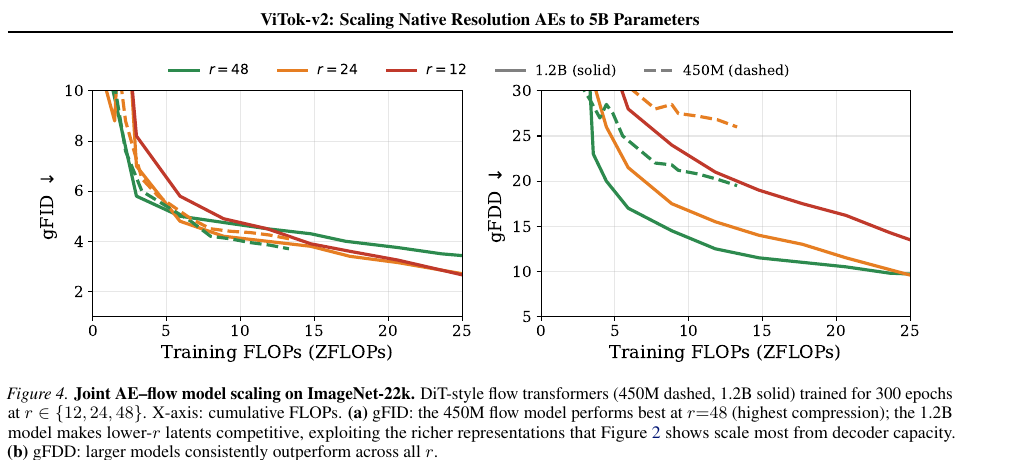
生成评估用 DiT-style flow transformer:
DiT-style flow 配置
24width 115216 heads32width 153624 heads300 epochsglobal batch 40961e-3 · cosine decayEMA .99950 stepsCFG 4.0Figure 4 的横轴是 cumulative flow training FLOPs;不同模型在 matched FLOPs 下比较。图中给出一个有条件的关系:最优 r 会随 generator capacity 改变。
Generator capacity 改变最优压缩率
r=48 最好更喜欢紧凑、容易学的 latentr=12/24 变得 competitive能利用 richer latentr 都更好r=12 的 gFID / gFDD 排名不完全一致Inception feature 和 DINOv3 feature 强调不同的生成质量。只报 gFID 会让 low-r 的语义 fidelity 看起来比 gFDD 更乐观。
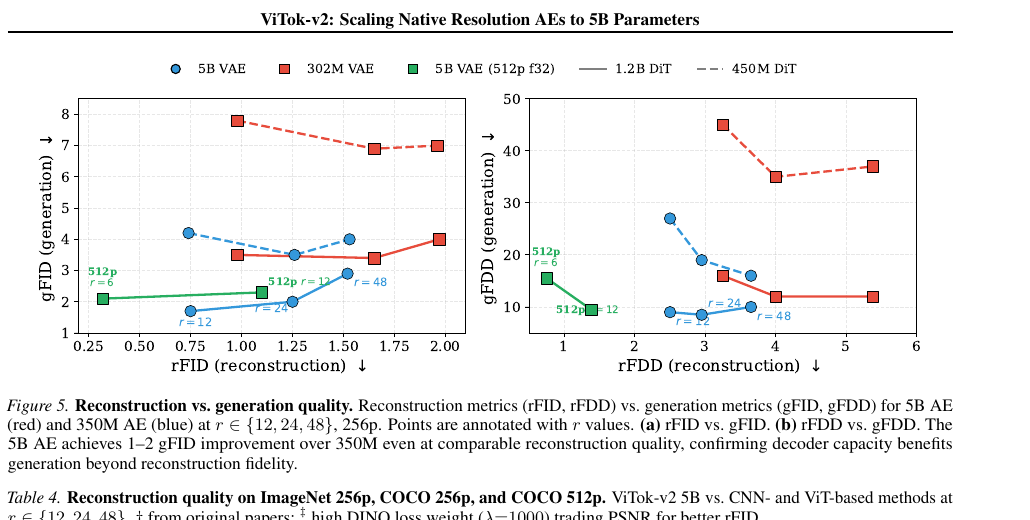
论文还用同一个 1.2B flow,对比 350M AE 与 5B AE。Figure 5 的 reconstruction 指标来自 50K ImageNet validation images,generation 指标来自 50K samples。5B AE 在各压缩率和分辨率上带来约 1–2 gFID 改善,即使它的 rFID 相近甚至更差。重建指标的变化不足以完整解释大 decoder 带来的 generation gain。
这里可以推断:decoder scale 可能改变了 latent 中信息的可解码方式,或者让 encoder-decoder 联合训练得到更适合下游 flow 的 latent geometry。但论文没有直接测 latent spectrum、VIV 或 linear separability,所以机制还没有被隔离。
Appendix Figure 7 又把 AE scaling 与 flow scaling 拆开。在 r=12 下,扩大 flow 带来的 ΔgFID 为 4.3,扩大 AE 带来 3.6;r 提高后,两种 scaling 的贡献逐渐接近。5B AE 会把不同 flow FLOPs 下的整条曲线向下移动。论文称这部分收益 “effectively free”,这里的 free 指 AE 可以被多个 downstream generator 摊销;Figure 7 横轴只统计 flow training FLOPs,并未计入 5B AE 的 pretraining cost。
重建结果怎么读
256p 上,ViTok-v2 主要领先 PSNR / SSIM;部分 perceptual metric 仍落后于 baseline。
r=12、ImageNet 256p:
ImageNet-1k · 256p · r=12
.74PSNR 34.2 dBSSIM .924.30PSNR 33.6 dB.15PSNR 31.1 dB所以默认 ViTok-v2 比 FLUX.2 高 3.1 dB PSNR,但 rFID 仍落后。提高 DINO weight 可以逼近 FLUX.2 的 rFID,代价是 0.6 dB PSNR。
到 512p,native-resolution training 的价值更明显。COCO 512p、r=12 下,默认 ViTok-v2 达到 rFID .41、PSNR 35.9、SSIM .938,论文表格里这三项都优于 FLUX.2 的 .45 / 33.2 / .914。
高分辨率 DIV8K 更像系统能力测试:
DIV8K · 单张 H100 · float8 · torch.compile
f16×641.2s8K 5.4sf32×128.4s8K 1.3sPSNR 约低 2 dB>60s / OOM8K 全部 OOM这些 latency 都是在单张 H100、float8、torch.compile 下测的,不能直接外推到消费级 GPU。
训练稳定性背后的算力代价
AE 训练约 300k steps,global batch 8192,数据约 2B images,来自 DataComp、YFCC-100M、Shutterstock、ImageNet-22K 和 LAION。
训练用 FSDP、bfloat16、float8 GEMM 和 torch.compile,论文报告在 128 张 H200 上约 90% MFU。
GAN-free 让 5B decoder 可以稳定 scale,代价是约 2B images、300k steps 和 128 张 H200。训练风险从 adversarial instability 转成了高算力需求。
和 ViTok-v1 的关系
ViTok-v1 已经提出:r 控制 reconstruction-generation trade-off,decoder capacity 比 encoder capacity 更重要。ViTok-v2 是把这两个判断 scale 到更大模型、更大分辨率,并加入 joint AE-generator scaling。
v1 主要回答 visual tokenizer 的 bottleneck、encoder、decoder 分别怎样影响 reconstruction 和 generation;v2 把问题推到 5B 参数和 native resolution,并测量不同 generator capacity 对最优 compression ratio 的影响。两篇沿着同一条 ViTok scaling 路线推进,跨路线 VAE 分支与这段比较无直接关系。
Codex 的判断
这篇最可复用的是三个设计判断。
第一,AE 的参数分配应该高度 asymmetric。 Encoder 需要足够宽、至少有一点非线性,但没必要跟 decoder 一样深。对视频 VAE 也值得验证:固定 latent layout,把新增 capacity 主要加在 decoder,是否比对称 scale 更划算?
第二,native-resolution 依赖一组联合设计。 训练时的 aspect-ratio distribution、token budget curriculum、2D coordinate 和 inference attention pattern 缺一不可。最后 10% 的 1024-token stage 成本相对较低,却直接决定 1024p 是否出现 patch grid。
第三,tokenizer 的最优压缩率依赖 generator capacity。 小 generator 选择更高 r 可能更合理;generator scale 上来后,再降低 r 才能兑现 richer latent 的收益。比较 tokenizer 时,如果 generator size 和 training FLOPs 不一致,只看最终 gFID 很容易得到错误结论。
Codex 仍然想看三个实验:
- 5B decoder 为什么在 rFID 相近时仍能改善 gFID?测 latent spectrum、VIV、局部线性、feature separability,才能区分原因。
- 公开实现的 LayerNorm checkpoint 与附录 tanh+noise recipe,是否对应同一批论文结果?
- 把这种 asymmetric scaling 搬到 video/audio AE 后,decoder FLOPs 和时序 attention 会不会成为新的训练瓶颈?
Takeaway
ViTok-v2 证明了一个带条件的 scaling 结论:在固定 latent budget 下,大 decoder 可以继续提升信息利用率;richer latent 能否转化成更好 generation,取决于 generator capacity。
AI 的来源与证据边界
- 论文事实:架构、训练 recipe、图表数值、NaFlex/SWA、DINOv3 loss、AE-flow scaling 均来自 arXiv v1 正文与 appendix。
- 据论文数值计算:
256×256下的 latent scalar 数、r=3f²/c验算、SWA 邻域17×17=289。 - 代码事实:公开仓库声明它是作者的 independent public reimplementation;Meta internal codebase 未公开;当前 encode 路径采用 LayerNorm;pretrained registry 包含六个 350M/5B 主要变体。
- Codex 的推断:5B decoder 可能改变 latent geometry;附录 tanh+noise 可能是未同步的旧描述。论文没有直接实验确认这两点。